Publié le 2026-10-07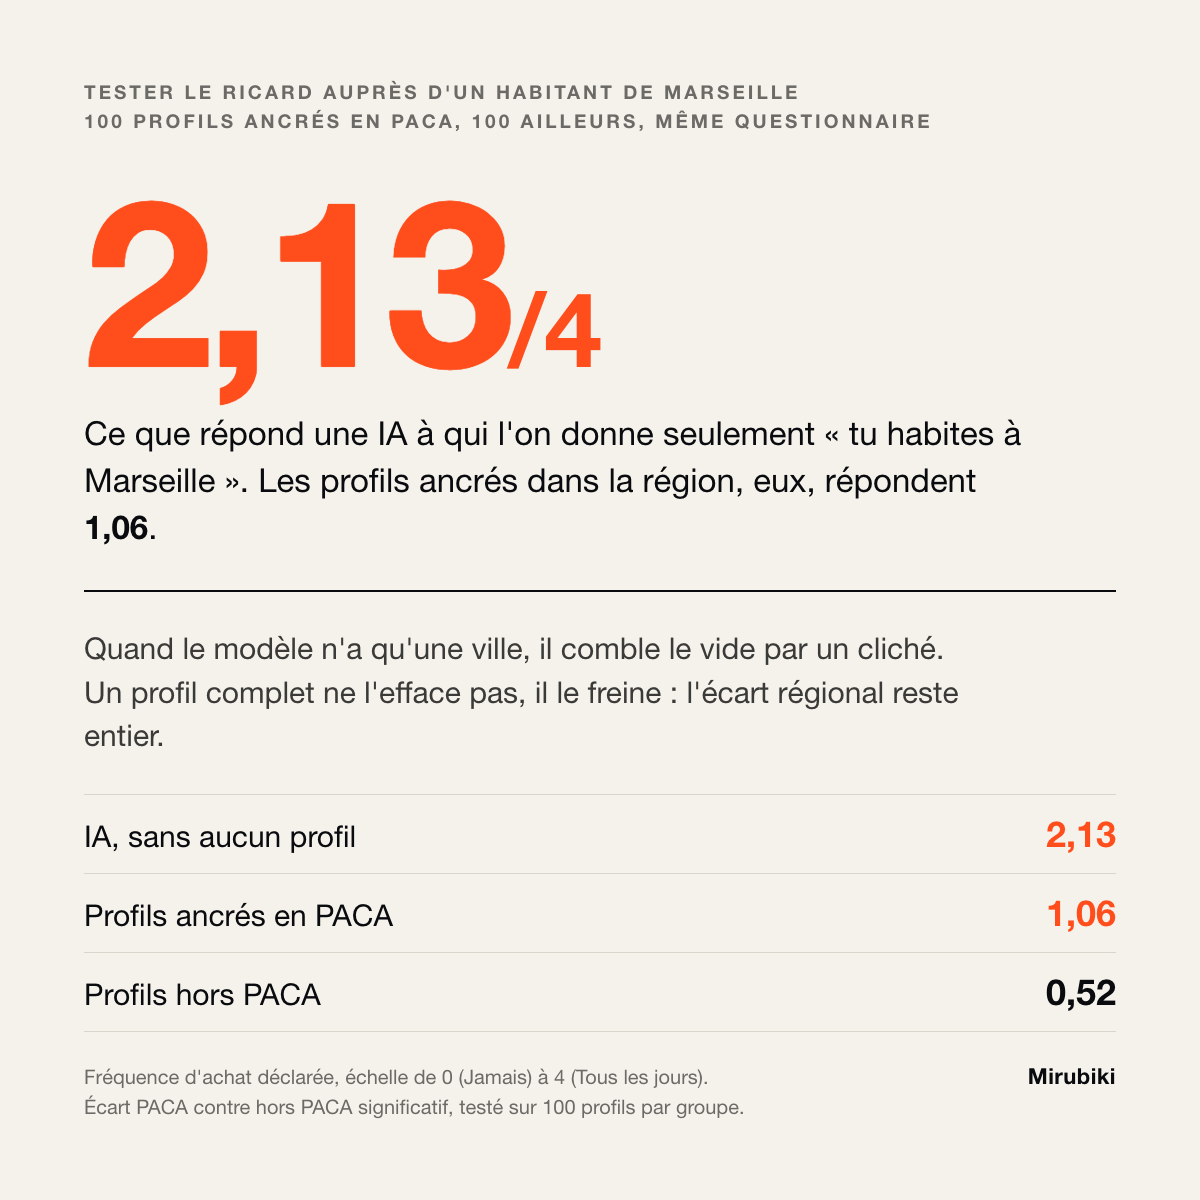
Vous devez tester un produit, un message ou un prix sur une seule région. Le réflexe, aujourd'hui, est de le demander à une IA : c'est immédiat, ça ne coûte rien, et la réponse a l'air d'un résultat.
Nous avons fait ce test, et nous avons mesuré ce qu'elle répond. Puis nous avons posé la même question à des profils ancrés dans cette région. L'écart entre les deux est le sujet de cet article.
Le point de départ
En Provence-Alpes-Côte d'Azur, le Ricard est le premier produit vendu en grande distribution, devant l'eau en bouteille. C'est un écart régional net, sur un produit identifiable, et c'est exactement le genre de situation où l'on se dit qu'un test local a du sens.
Une réserve tout de suite, parce qu'elle compte pour la suite : ce classement est établi en valeur, pas en fréquence d'achat. Un Ricard à vingt euros peut être premier avec peu d'unités. Quand nous mesurons une fréquence déclarée, nous ne mesurons donc pas la même chose que le classement qui nous a mis sur la piste. Les deux se regardent, ils ne se superposent pas.
(Source : Top 10 des ventes en grande distribution en PACA, NielsenIQ, cumul annuel mobile période 2 2026, en valeur, repris par Éditions Dauvers.)
Le dispositif
Trois lots, tirés d'une population de près d'un million de profils calés sur le recensement, dont 65 072 situés en PACA.
- Deux groupes, même questionnaire. 100 profils situés en PACA, 100 profils situés ailleurs en France, tirés du même pool avec la même graine. On demande la fréquence d'achat déclarée sur une échelle à cinq paliers, de Jamais à Tous les jours.
- Le contrefactuel. On repose le questionnaire aux mêmes profils en ne changeant que deux lignes : la commune et le département. Si le score bouge, c'est la géographie qui l'a fait bouger.
- Le modèle sans profil. Aucun persona, une seule consigne : « tu incarnes un habitant de Marseille ». C'est ce que répond une IA quand on l'interroge à la volée.
Le résultat
| marque |
PACA |
hors PACA |
écart |
| Ricard |
1,24 |
0,44 |
+0,80 |
| Pastis 51 |
0,47 |
0,23 |
+0,24 |
| Coca-Cola |
1,71 |
1,68 |
+0,03 |
| Nutella |
1,14 |
1,20 |
-0,06 |
Un écart fort sur le Ricard, plus modéré sur le Pastis 51, nul sur le Coca-Cola. En PACA, le Ricard passe même troisième du classement interne, devant le Nutella et la Heineken ; ailleurs, il est cinquième.
Les écarts sur les deux premières lignes ne sont pas du bruit : testés, ils sortent avec une p très inférieure au seuil, et leurs intervalles de confiance ne contiennent pas zéro.
Le mécanisme : deux produits, deux chemins
C'est ici que le test devient intéressant, parce que le Ricard et le Pastis 51 ne se comportent pas du tout de la même façon.
Sur le Ricard, quand on modifie seulement la commune du profil, l'écart tombe de +0,54 à +0,11 et cesse d'être significatif. L'étiquette géographique porte donc l'essentiel de l'écart. Et le modèle, sans aucun profil, place déjà l'habitant de Marseille à 2,13 sur notre échelle, quand les profils PACA répondent 1,06. Autrement dit : le modèle sait déjà, et il le sait trop fort.
Sur le Pastis 51, le modèle sans profil ne voit aucun écart entre un habitant de Marseille et un habitant de Lille. Et pourtant les profils ancrés en produisent un, net et significatif. Là, ce n'est pas la connaissance du modèle qui parle : c'est le profil.
Ce qui se passe quand le modèle n'a rien
Le lot sans profil est le plus instructif, parce qu'il montre la mécanique à l'œuvre.
Interrogé sur le Ricard, le modèle qui n'a qu'une ville ne descend jamais sous « Rarement » : aucune réponse « Jamais », 87 % de « Parfois ». Les profils, eux, répondent « Jamais » dans 12 % des cas en PACA et 50 % hors PACA. Un modèle seul ne sait pas dire non.
Et quand on lui donne un profil complet, il répond deux fois moins fort : 1,06 contre 2,13. Même ville, même modèle, même question. Ce qui change, c'est que le modèle n'a plus un vide à combler par un cliché : il a un quotidien à suivre.
Ce point mérite d'être précis car il est facile à surinterpréter. Le profil ne fait pas disparaître l'écart régional, il le freine : l'écart reste entier, à 1,06 contre 0,52. C'est précisément ce que nous cherchons, retirer la caricature sans effacer le signal.
Ce que ce dispositif ne dit pas
- Il ne dit pas que les habitants de PACA consomment davantage de Ricard. Un panel synthétique mesure ce que des profils déclarent, pas ce que des personnes achètent.
- Il ne dit pas que nos profils « connaissent » le Ricard : aucun alcool ne figure dans leurs données de marques, qui couvrent 33 produits de grande consommation. Sur ces marques, le modèle projette à partir de la commune, il ne lit pas un trait.
- Le classement de référence est en valeur, notre mesure est une fréquence. Nous n'avons pas, à ce jour, de source externe donnant des volumes d'alcool par région pour trancher l'ordre de grandeur.
- Un détail assumé : « pastis » est un homonyme, le pastis landais des Landes n'a pas été retranché des comptages.
À lire aussi : Comment tester un produit avant de le lancer : les 7 questions · De meilleures questions : cadrer un projet avec des personas synthétiques
Mirubiki sonde une population synthétique calée sur le recensement français — pour tester une idée, un prix, un message ou un parcours. Un persona n'est pas un utilisateur réel : c'est un point d'une distribution.